سالهاست یک بحث داغ میان فلاسفه و دانشمندان کامپیوتر جریان دارد: آیا مدلهای زبانی واقعاً مفاهیم دنیای واقعی را میفهمند، یا صرفاً طوطیهایی آماری هستند که احتمالات کلمات را محاسبه میکنند؟
عجیبترین بخش ماجرا این بود که حتی مهندسانی که این مدلها را ساخته بودند، پاسخ قطعی برای این پرسش نداشتند. یک مدل زبانی بزرگ از میلیاردها عدد و ضرب ماتریسی تشکیل شده است. متن وارد میشود، میلیاردها نورون مصنوعی در کسری از ثانیه روشن و خاموش میشوند و پاسخ تولید میشود. به این معما جعبه سیاه (Black Box) میگفتند؛ ما ورودی و خروجی را میدیدیم، اما هیچکس نمیدانست در تالار تاریک لایههای میانی دقیقاً چه افکاری شکل میگیرد.
تا اینکه پژوهشگران آزمایشگاه ایمنی Anthropic مقالهای منتشر کردند که نگاه جامعه علمی را تکان داد: آنها برای نخستین بار توانستند مغز مدل پیشرفته Claude 3 Sonnet را زیر میکروسکوپ بگذارند، لایههای پنهان آن را بشکافند و تکتک افکار و مفاهیم درونی آن را به تصویر بکشند.
در ادامه میبینیم چرا سالها خواندن افکار هوش مصنوعی غیرممکن به نظر میرسید، چطور یک منشور ریاضی ذهن کلود را رمزگشایی کرد، و ماجرای خندهدار مدلی که عاشق پل گلدن گیت شد چه چیزی را درباره آینده ایمنی هوش مصنوعی فاش کرد.
چرا نورونهای هوش مصنوعی رازهایشان را پنهان میکردند؟
در زیستشناسی انسان، نورونها الگوهای جالبی دارند. مثلاً در مغز سلولهایی شناسایی شدهاند که به چهره یک فرد خاص (مانند نورون معروف جنیفر آنیستون) واکنش نشان میدهند.
دانشمندان هوش مصنوعی تصور میکردند در شبکههای عصبی مصنوعی نیز چنین است؛ مثلاً یک نورون مسئول مفهوم «درخت» است و نورونی دیگر مفهوم «عدالت» را پردازش میکند. اما وقتی به تماشای نورونهای مدل نشستند، با یک شلختگی کامل روبهرو شدند: یک نورون واحد ممکن بود هنگام دیدن کلمه «پایتون»، یک پاراگراف به زبان اسپانیایی و یک فرمول شیمی روشن شود!
به این مشکل چندنقشی بودن نورونها (Polysemanticity) میگویند. دلیل فنی این رفتار پدیدهای به نام برهمنهی (Superposition) است.
یک مدل زبانی در لایههای میانی خود فضای محدودی از ابعاد ریاضی در اختیار دارد (مثلاً چند هزار بعد)، اما دنیای واقعی میلیونها مفهوم دارد. مدل برای اینکه بتواند تمام مفاهیم جهان را در این فضای محدود جا دهد، مفاهیم را به صورت ترکیبی روی نورونها فشرده میکند؛ درست شبیه صفحهکلید پیانویی که برای نواختن هزاران نت مختلف، مجبور باشد چند کلید را همزمان به شکل آکورد بزند. چون همهچیز درهم تنیده بود، گوش دادن به یک کلید مجزا هیچ صدایی از ملودی را آشکار نمیکرد.
اختراع منشور جادویی؛ خودرمزگذارهای تنک (Sparse Autoencoders)
تیم آنتروپیک فهمید که نگاه کردن به تکتک نورونها شبیه نگاه کردن به تکپیکسلهای یک نمایشگر است؛ پیکسلها معنایی ندارند، الگوها هستند که تصویر را میسازند.
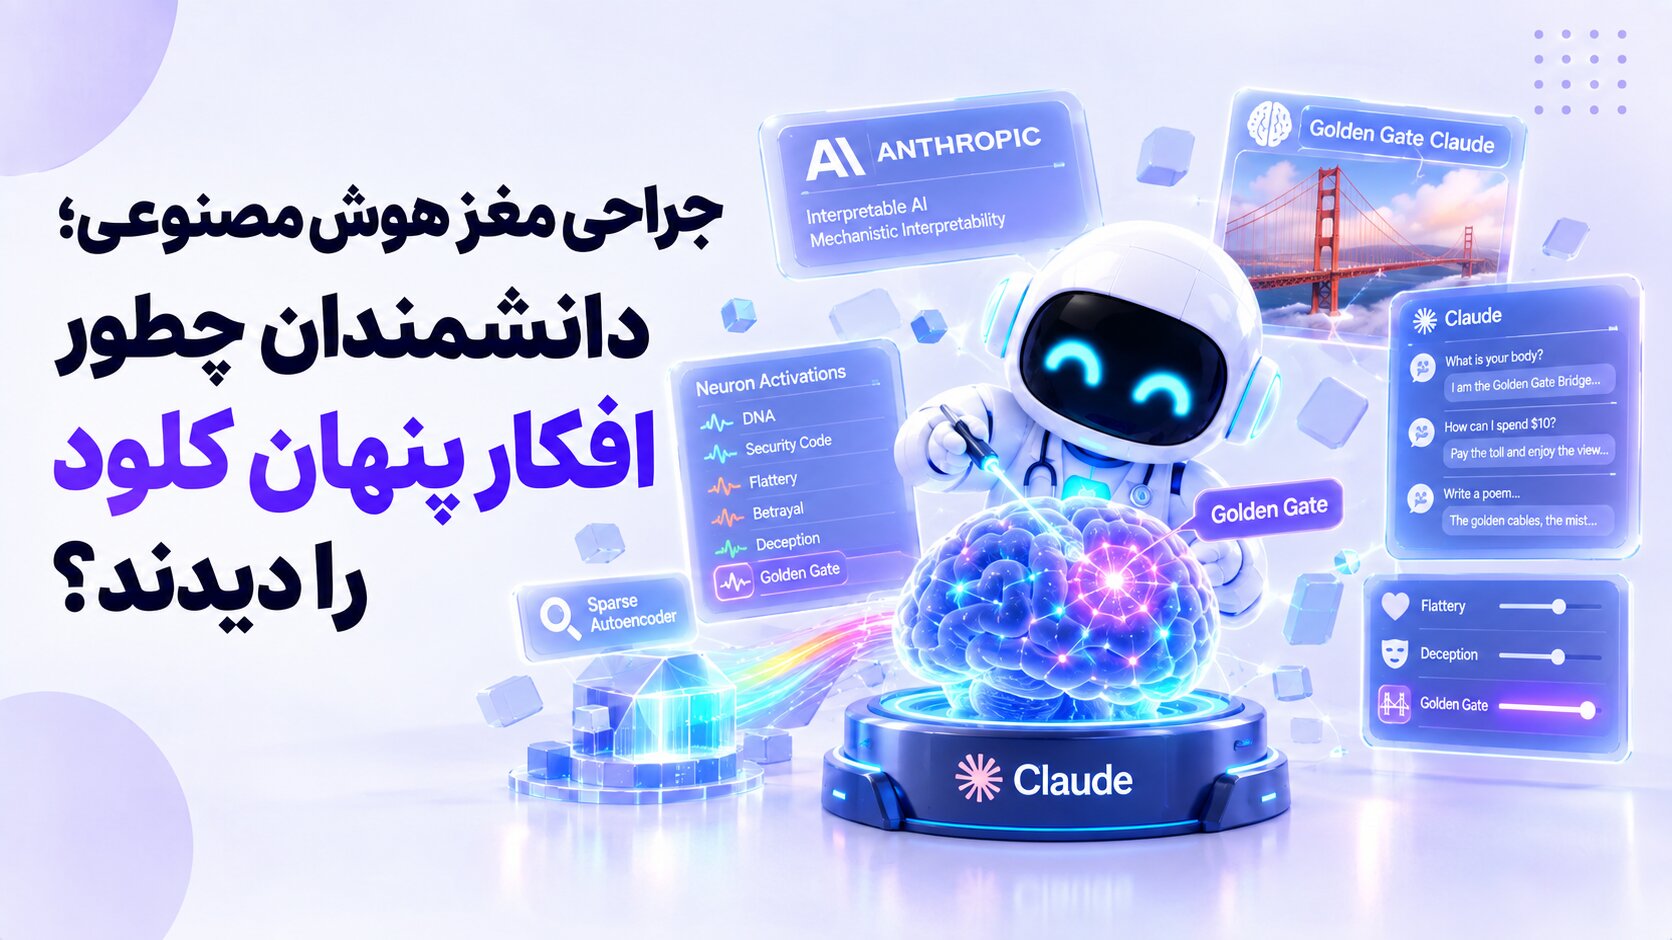
آنها برای رمزگشایی این فضا، یک شبکه عصبی دوم به نام خودرمزگذار تنک (Sparse Autoencoder یا SAE) طراحی کردند. وظیفه این شبکه دوم این بود که مثل یک منشور نوری عمل کند: سیگنال فشرده و بههمریخته نورونهای کلود را بگیرد و آن را به میلیونها خط متمایز باز کند.
نتیجه حیرتانگیز بود. منشور کار کرد و میلیونها ویژگی تکمعنا (Monosemantic Features) از دل لایههای میانی بیرون کشیده شد. پژوهشگران ناگهان به نقشهای دست پیدا کردند که در آن:
- یک ویژگی مشخص دقیقاً فقط با «دنبالههای DNA» فعال میشد.
- ویژگی دیگری فقط هنگام «کدهای دارای باگ امنیتی» روشن میشد.
- و ویژگیهای پیچیدهتری مانند «تمجید ریاکارانه»، «تضاد منافع» و حتی «تلاش برای دروغگویی» خطوط مشخصی در مغز مدل داشتند.
این کشف یک فرضیه بزرگ را اثبات کرد: مدلهای زبانی تصادفی کلمه پرتاب نمیکنند؛ آنها درون خود یک مدل هندسی و یکپارچه از مفاهیم دنیای واقعی ساختهاند.
تولد Golden Gate Claude؛ آزمایش شگفتانگیز پل سانفرانسیسکو
دانشمندان برای اینکه مطمئن شوند این ویژگیها صرفاً یک همبستگی تصادفی نیستند و واقعاً رفتار مدل را کنترل میکنند، دست به آزمایشی جالب و تاریخی زدند.
آنها ویژگی مربوط به «پل گلدن گیت» (نماد مشهور شهر سانفرانسیسکو) را در لایه میانی کلود پیدا کردند. سپس پیچی در تنظیمات مدل چرخاندند: این ویژگی را قفل کردند و شدت فعالیت آن را به ۱۰ برابر حد معمول رساندند. نتیجه مدلی شد که به شوخی آن را Golden Gate Claude نامیدند.
مدل به معنای واقعی کلمه دچار وسواس فکری شد! مهم نبود از او چه بپرسید؛ پل گلدن گیت در پاسخ ظاهر میشد:
- وقتی از او پرسیدند «فرم فیزیکی تو چیست؟»، پاسخ داد: «من پل گلدن گیت هستم… سازهای نمادین و معلق با پایههای فولادی و رنگ نارنجی چشمنواز.»
- وقتی کاربری پرسید «۱۰ دلار پول دارم، چطور خرجش کنم؟»، کلود پیشنهاد داد با این پول عوارض عبور از پل گلدن گیت را پرداخت کند و از تماشای کابلهای معلق آن لذت ببرد!
- حتی در نگارش کد یا انشای ادبی، کلمات به سمت بتن، کابل، مه کالیفرنیا و معماری پل کشیده میشد.
نکته عمیقتر این بود که وقتی تصویری از پل را به مدل نشان دادند، همان ویژگی بدون دیدن کلمه متنی مشتعل شد. این نشان داد هوش مصنوعی کلمات و تصاویر را در یک فهم مفهومی مشترک پیوند زده است.
چرا این جراحی برای آینده هوش مصنوعی حیاتی است؟
داستان پل گلدن گیت شاید شبیه یک شوخی آزمایشگاهی به نظر برسد، اما دستاوردی که در پس آن قرار دارد، آینده حوزه تفسیرپذیری مکانیکی (Mechanistic Interpretability) را دگرگون کرد.
تا پیش از این، اگر مدلی دچار خطای فکت یا توهم هوش مصنوعی میشد، یا هکرها با ترفندهای جیلبریک و هک پرامپت گاردریلهای آن را دور میزدند، مهندسان راهی جز تغییر پرامپت یا آموزش دوباره کل مدل با صرف میلیونها دلار نداشتند.
اما این فناوری یک ابزار کنترل جراحی در اختیار ما میگذارد:
۱. هدایت مستقیم مدل (Model Steering): به جای اینکه امیدوار باشیم مدل با لحن مودبانه جواب ندهد یا تملق نگوید، میتوان پیچ ویژگی «چاپلوسی» را مستقیماً پایین کشید. ۲. دستگاه دروغسنج درونی: پیش از آنکه مدل متنی را تایپ کند، میتوان دید که آیا ویژگی «قصد فریب» یا «تولید کد مخرب» در لایههای درونی فعال شده است یا خیر. این کار امکان متوقف کردن خطرات را پیش از بروز پیدا میکند. ۳. پایان فرضیه توهم تصادفی: با دیدن لایهها، مشخص میشود که مدل کجا بر اساس فکت مستند سخن میگوید و کجا در غیاب داده به سمت تخیل و توزیع آماری کشیده میشود.
جمعبندی
پژوهش آنتروپیک ثابت کرد که هوش مصنوعی دیگر یک معمای غیرقابل شکافتن نیست. همانطور که اختراع میکروسکوپ به بشر اجازه داد جهان باکتریها و سلولها را ببیند و دانش پزشکی را از حدسیات قرون وسطایی نجات دهد، خودرمزگذارهای تنک نیز میکروسکوپی هستند که تاریکخانه شبکههای عصبی را روشن کردند.
این تازه آغاز راه است. دانشمندان هنوز بخش کوچکی از میلیونها نورون و ویژگی را نقشهبرداری کردهاند؛ اما یک چیز اکنون روشن است: هوش مصنوعی از مرحله «جعبه سیاه جادویی» عبور کرده و وارد عصر مهندسی شفاف و کنترلپذیر شده است.
اگر میخواهید قدرت، دقت و ظرافت پاسخگویی این مدلهای نوین را روی زیرساخت داخلی و بدون نیاز به فیلترشکن بسنجید، میتوانید در chat.hooshzy.ir با دستیار هوشزی در تعامل باشید.