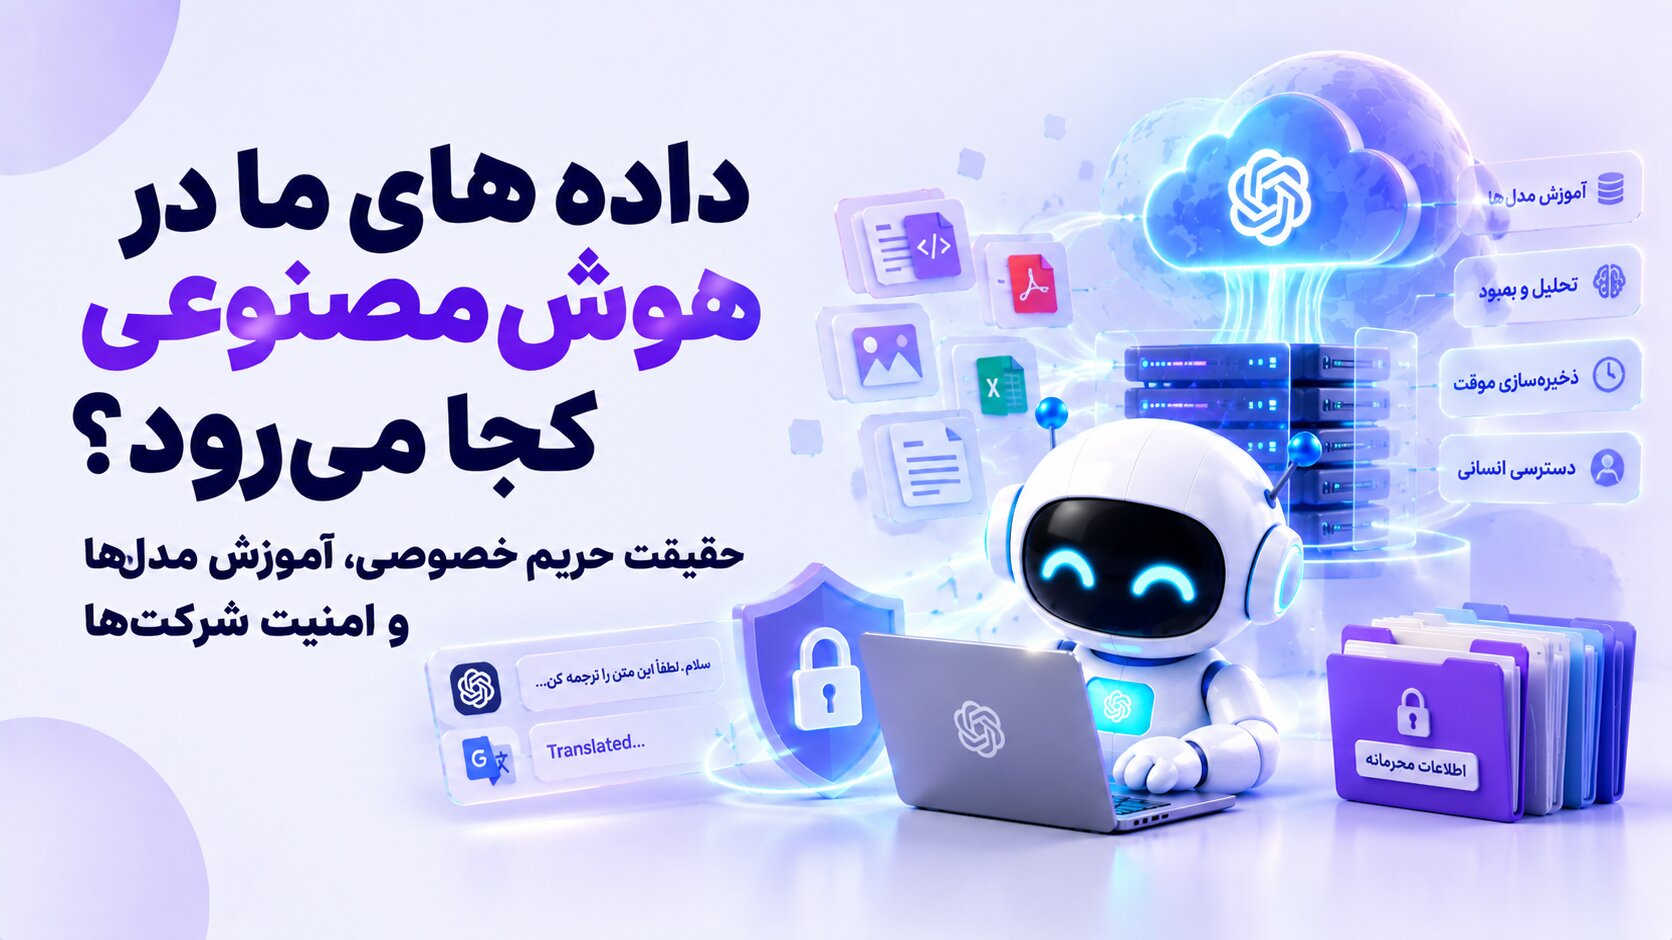
یک حسابدار ترازنامه مالی محرمانه شرکت را برای فرمولنویسی در چتبات پیست میکند؛ یک وکیل متن پیشنویس قراردادی محرمانه را برای غلطگیری ارسال میکند؛ و یک برنامهنویس کدهای اصلی بکاند سازمان را برای پیدا کردن یک باگ اعصابخردکن به هوش مصنوعی میسپارد. همه این افراد یک هدف مشترک دارند: «سریعتر انجام دادن کارها». اما هیچکدام یک ثانیه مکث نمیکنند تا از خود بپرسند: این دادهها الان دقیقاً کجاست و چه بلایی سرشان میآید؟
بزرگترین خطر هوش مصنوعی هکرهای کلاهسیاه نیستند؛ بلکه کارمندان باانگیزهای هستند که ناخواسته رازهای سازمان را به خورد سرورهای ابری میدهند. در این مقاله به زبان شفاف و مستند فنی، مسیر حرکت دادهها در مدلهای زبانی، پروندههای واقعی نشت اطلاعات و حقیقت حقوقی حریم خصوصی برای شرکتهای ایرانی را کالبدشکافی میکنیم.
چرخه حیات داده در چتباتها؛ از زدن دکمه Send تا مغز مدل
وقتی متنی را داخل یک مدل زبانی ابری (Cloud LLM) ارسال میکنید، پیام شما در سه مرحله مجزا پردازش میشود:
۱. پردازش آنی در حافظه موقت (Inference)
در ثانیههای اول، متن شما به توکن تبدیل شده و از لایههای عصبی عبور میکند تا پاسخ بعدی تولید شود. این مرحله خطری برای درز عمومی ندارد چون در حافظه رم (RAM) سرور رخ میدهد.
۲. ورود به لاگهای نظارتی (Abuse Monitoring & 30-Day Window)
مسئله اصلی از این نقطه آغاز میشود. حتی اگر گزینه آموزش مدل را در تنظیمات خاموش کنید یا از چت موقت (Temporary Chat) استفاده کنید، شرکتهای بزرگ مثل OpenAI، گوگل و آنتروپیک دادهها را بر اساس خطمشی نگهداری (Data Retention Policy) تا ۳۰ روز در سرورهای خود نگه میدارند. این لاگها برای بررسی سوءاستفادههای امنیتی نگهداری میشوند و نیروهای انسانی ناظر بر سیستم (Human Reviewers) در موارد خاص به آنها دسترسی دارند.
۳. بلعیده شدن در دادههای آموزشی (Model Training)
در حسابهای کاربری عادی و رایگان، اگر گزینه «Improve the model for everyone» را غیرفعال نکرده باشید، متنی که نوشتید به استخر دادههای آموزشی (Training Dataset) اضافه میشود. وقتی داده وارد مرحله آموزش شد، دیگر یک فایل روی هارد نیست که بتوان آن را دیلیت کرد؛ آن متن تبدیل به وزنهای ریاضی (Weights) در شبکه عصبی میشود.
دام «فراموشنشدن»؛ چرا داده بلعیدهشده را نمیتوان پاک کرد؟
یکی از بزرگترین چالشهای مهندسی هوش مصنوعی، مسئلهای به نام یادگیریزدایی ماشینی (Machine Unlearning) است. اگر شما اطلاعات محرمانه یک پروژه یا کد نرمافزاری خود را به یک مدل بدهید و آن داده وارد فاز آموزش مدل نسل بعدی شود، بیرون کشیدن آن داده تقریباً غیرممکن است.
این همان پدیدهای است که در تستهای پژوهشی دانشگاهی بارها اثبات شده است: مدل با دریافت سرنخهای مشابه، کدهای محرمانه و ساختارهای پروژههای داخلی شرکتها را در پاسخ به کاربران کاملاً غریبه در آن سوی کره زمین بیرون میریزد! دادهای که وارد وزنهای مدل شد، برای همیشه در حافظه جمعی آن حل شده است.
پرونده سامسونگ؛ زنگ خطری که اصطلاح «سایه هوش مصنوعی» را ساخت
یکی از مستندترین موارد نشت اطلاعات در تاریخ هوش مصنوعی، اوایل سال ۲۰۲۳ در بخش نیمههادی شرکت سامسونگ (Samsung Semiconductor) رخ داد. در یک بازه زمانی کمتر از بیست روز، سه فاجعه پیاپی توسط کارمندان رقم خورد:
- یک مهندس، سورسکد محرمانه اندازهگیری و تست چیپهای نیمههادی را برای دیباگ کردن در ChatGPT پیست کرد.
- مهندس دوم، کدهای بهینهسازی توالی پردازندههای گرافیکی را برای تبدیل سینتکس وارد چت کرد.
- مهندس سوم، فایل صوتی پیادهشده از یک جلسه محرمانه راهبردی و محرمانه شرکت را برای خلاصهسازی به مدل سپرد.
نکته تکاندهنده ماجرا این بود: هیچ نفوذی به فایروال سامسونگ انجام نشده بود، هیچ بدافزاری وجود نداشت و کارمندان هم خائن نبودند؛ آنها فقط میخواستند کارشان سریعتر جلو برود!
این فاجعه باعث متولد شدن اصطلاح سایه هوش مصنوعی (Shadow AI) در ادبیات امنیت سایبری شد؛ یعنی استفاده کارمندان از ابزارهای هوش مصنوعی مصرفی بدون نظارت و تأیید تیم امنیت شبکه سازمان. پس از این ماجرا، سامسونگ و دهها غول مالی والاستریت مانند JPMorgan استفاده از ابزارهای ابری را روی شبکه داخلی ممنوع کردند.
توهم توافقنامه سازمانی؛ تفاوت جهان غرب با واقعیت ایران
شرکتهای بینالمللی در اروپا و آمریکا برای فرار از این ریسک، قراردادهای اختصاصی سازمانی (Enterprise Agreements) یا گواهیهای عدم نگهداری داده (Zero Data Retention - ZDR) امضا میکنند که در آن شرکت ارائهدهنده با امضای تعهدنامه رسمی تضمین میدهد دادهها هرگز ذخیره یا مشاهده نشوند.
اما برای یک شرکت، استارتاپ یا متخصص ایرانی، ماجرا کاملاً برعکس و بسیار خطرناک است:
- نبود هیچگونه پوشش حقوقی (Zero Legal Protection): هیچ شرکت ایرانی نمیتواند با شرکتهای آمریکایی قرارداد رسمی حریم خصوصی (DPA یا BAA) ببندد.
- استفاده از هویتهای جعلی و تحریمشکن: اکثر کاربران و شرکتها با فیلترشکن، آیپی متغیر و شمارههای مجازی خارجی از این ابزارها استفاده میکنند.
- خطر بستهشدن ناگهانی اکانت (Account Ban): اگر سیستم امنیتی هوش مصنوعی متوجه مبدأ اتصال شود، کل حساب کاربری، فایلهای آپلودشده و تاریخچه بدون اخطار قبلی پاک یا مصادره میشود و هیچ مرجع قضایی یا پشتیبانی به آن پاسخ نخواهد داد.
- عبور داده از مسیرهای پروکسی ناامن: متنی که در مرورگر ارسال میشود، قبل از رسیدن به سرور هوش مصنوعی از سرورهای واسط فیلترشکن رد میشود؛ جایی که احتمال شنود و کپی دادهها وجود دارد.
راهحل واقعی چیست؟ حاکمیت داده با مدلهای محلی (On-Premise)
وقتی نمیتوان هوش مصنوعی را متوقف کرد و از طرفی نمیتوان دادههای حساس را به سرورهای ابری خارجی فرستاد، راهحل مهندسی چیست؟
پاسخ در یک مفهوم حیاتی خلاصه میشود: حاکمیت داده (Data Sovereignty).
همانطور که در مقاله مدلهای متنباز و وزنباز هوش مصنوعی بررسی کردیم، سازمانها دیگر نیازی به تکیه بر خدمات ابری خارج از کنترل ندارند. مدلهای هوش مصنوعی را میتوان روی دیتاسنترها و سرورهای داخلی میزبانی کرد.
چرا میزبانی روی سرورهای داخلی امنیت را تضمین میکند؟
- عدم خروج ترافیک از شبکه ملی: دادههای حسابداری، قراردادها و کدهای شما حتی یک میلیثانیه وارد اینترنت بینالملل یا مسیرهای ناشناخته نمیشوند.
- ایمنی در برابر تحریم و فیلترینگ: هیچ شرکت خارجی نمیتواند دسترسی شما را مسدود کند یا اسناد را به گروگان بگیرد.
- صفر بودن ریسک آموزش مجدد: مدلهای محلی فقط در نقش پردازشگر عمل میکنند و هیچ دادهای را برای کمپانیهای دره سیلیکون ارسال نمیکنند.
این دقیقاً زیربنایی است که پلتفرم هوشزی بر اساس آن طراحی شده است؛ استقرار مدل روی سرورهای داخلی دیتاسنتر کشور برای اینکه کاربران و تیمها بتوانند بدون نگرانی از شنود، فیلترشکن یا نشت اطلاعات محرمانه، امور روزمره خود را جلو ببرند.
چکلیست ۴ گانه امنیت قبل از زدن دکمه ارسال (Send)
پیش از آنکه هر متنی را به هر چتباتی بفرستید، این ۴ اصل را رعایت کنید:
- اصل بینامسازی (Anonymization): قبل از ارسال قراردادها یا صورتجلسات، نام افراد، نام برند، مبالغ واقعی، شماره حسابها و شماره تماسها را با عبارات فرضی مثل «شرکت الف» یا «مبلغ X» جایگزین کنید.
- پاکسازی سورسکد (Sanitization): هرگز کدی که حاوی کلیدهای دسترسی (API Keys)، پسورد دیتابیس یا آدرس آیپی سرورهای شرکت است را در هوش مصنوعی کپی نکنید.
- غیرفعالسازی ذخیره چت در اکانتهای خارجی: اگر از چتباتهای خارجی استفاده میکنید، فوراً وارد بخش Data Controls شوید و تیک «Improve the model» را خاموش کنید.
- تفکیک دادههای حیاتی از دادههای عمومی: از هوش مصنوعی برای تولید ایده، ساختار متن، ترجمه و کارهای عمومی استفاده کنید؛ اما مغز تجاری و دادههای خام مشتریانتان را در حصار سرورهای امن محلی نگه دارید.
هوش مصنوعی ابزاری بینظیر برای سرعت بخشیدن به کارهاست، اما فقط تا زمانی که خودتان صاحب دادههایتان باقی بمانید.