کابوس این روزهای دانشجویان، محققان و تولیدکنندگان محتوا این است: ساعتها برای نوشتن یک مقاله یا پایاننامه زحمت میکشند، اما در نهایت استاد یا کارفرما متن را در یک سایت رایگان پیست میکند و میگوید: «این متن را هوش مصنوعی نوشته، ۷۸٪ درصد تشابه زده!»
اما این ابزارها واقعاً چطور کار میکنند؟ آیا الگوریتمی وجود دارد که بتواند رد پای ذهن مصنوعی را در میان کلمات پیدا کند؟ یا اینکه با یک حدس آماری ناقص طرفیم که قربانیان بیگناه میگیرد؟
در این مقاله بر پایهی پژوهشهای مستند علمی از جمله آزمایش معروف دانشگاه استنفورد، پشت صحنهی ریاضی ابزارهای تشخیص متن (AI Detectors)، دلایل خطای فاجعهبار آنها در زبان فارسی و روشهای علمی اثبات اصالت متن را بررسی میکنیم.
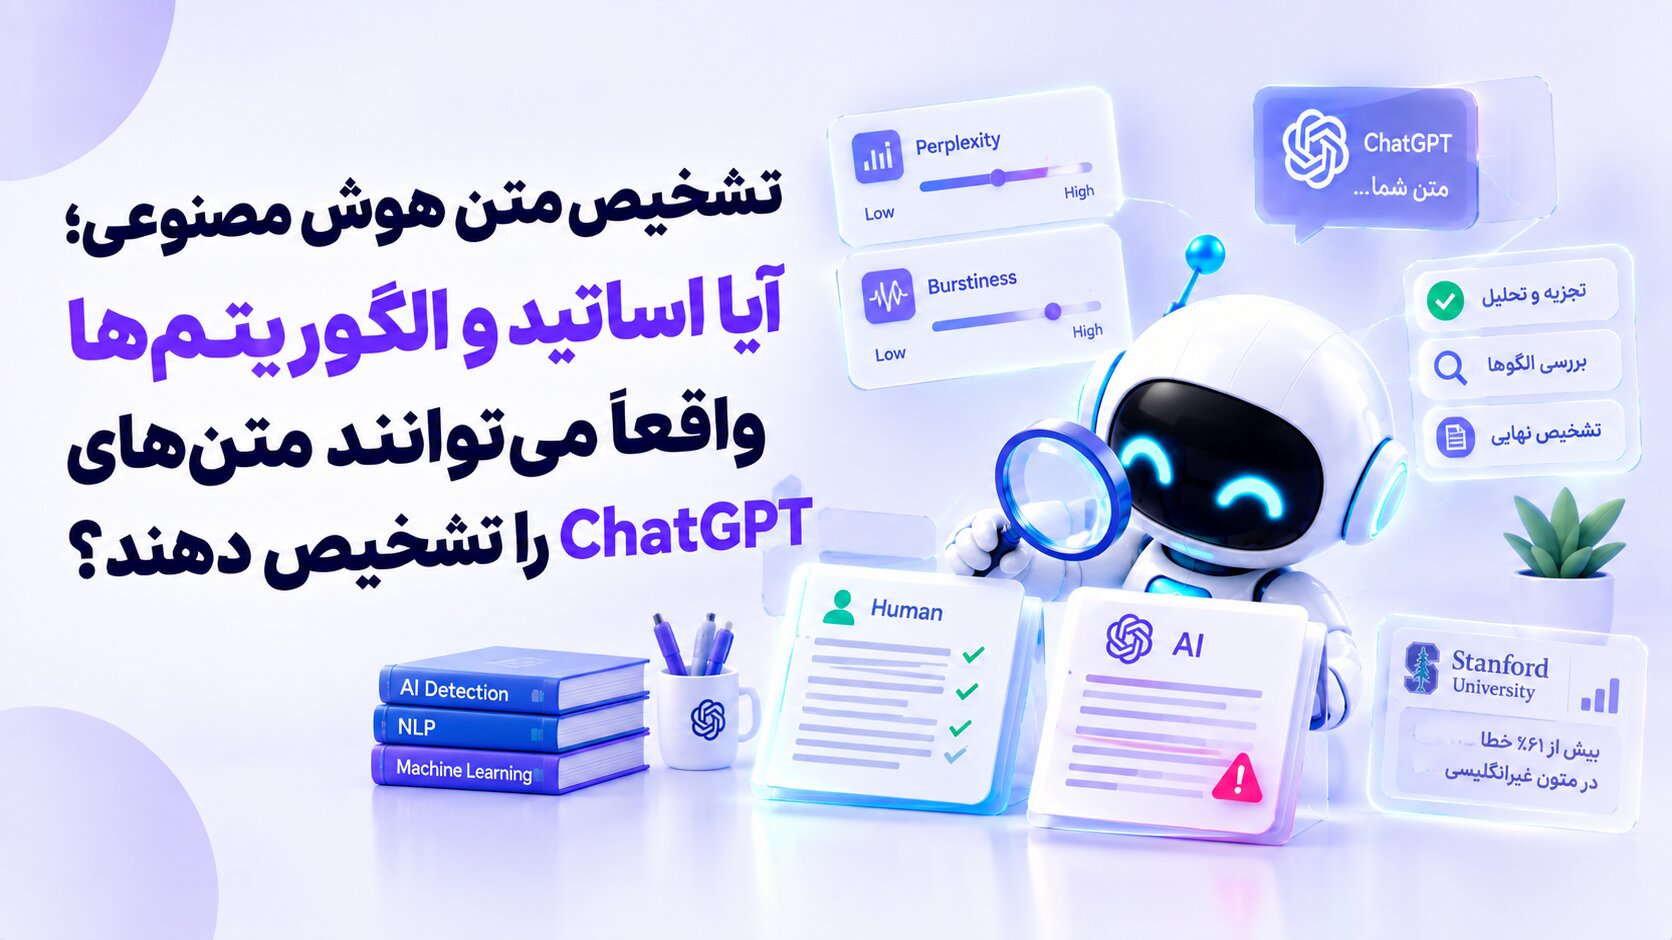
ابزارهای تشخیص چه چیزی را میسنجند؟ (راز دو شاخص ریاضی)
برخلاف باور عمومی، ابزارهایی مثل GPTZero، ZeroGPT یا Turnitin هیچ نشانهگذاری مخفی یا واترمارک دیجیتالی در متن پیدا نمیکنند. مدلهای زبانی مانند ChatGPT در پایان هر جمله امضایی از خود به جا نمیگذارند.
کاری که این ابزارها انجام میدهند، سنجش دو متغیر آماری در متن است:
۱. پرپلکسیتی (Perplexity) یا «میزان غافلگیری»
مدلهای زبانی هوش مصنوعی بر اساس احتمال آماری کلمات کار میکنند؛ آنها همیشه محتملترین و منطقیترین کلمه بعدی را حدس میزنند.
- پرپلکسیتی پایین: متنی که کلماتش کاملاً قابل پیشبینی، استاندارد و بدون غافلگیری باشد. این یعنی خروجی به سبک هوش مصنوعی نزدیک است.
- پرپلکسیتی بالا: متنی که کلمات غیرمنتظره، استعارههای خلاقانه و ترکیبهای واژگانی نامتعارف داشته باشد؛ چیزی که معمولاً از ذهن انسان سرچشمه میگیرد.
۲. برستینس (Burstiness) یا «تنوع ریتم جملات»
انسانها حین نوشتن ریتم متغیری دارند؛ گاهی یک جمله سه کلمهای تند مینویسند و بلافاصله بعد از آن یک جمله سه خطی پیچیده با چند حرف ربط میآورند.
- هوش مصنوعی معمولاً جملاتی با طولهای منظم، پاراگرافهای متقارن و ضربآهنگ یکنواخت تولید میکند (برستینس پایین).
- نوشته انسان پر از پرش، تغییر ناگهانی طول جمله و تغییر لحن است (برستینس بالا).
اگر متنی هم کلمات قابل پیشبینی داشته باشد و هم طول جملاتش یکدست باشد، دیتکتور فوراً دکمه قرمز را فشار میدهد و اعلام میکند: «این متن کار هوش مصنوعی است!»
پژوهش دانشگاه استنفورد؛ وقتی بیگناهان مجرم شناخته میشوند
در سال ۲۰۲۳، گروهی از پژوهشگران ارشد دانشگاه استنفورد (Liang et al) آزمایشی تاریخی انجام دادند. آنها مقالاتی که کاملاً توسط انسان نوشته شده بود را به ۷ ابزار مطرح تشخیص هوش مصنوعی در دنیا دادند. نتایج تکاندهنده بود:
- در مقالات دانشآموزان بومی آمریکایی، ابزارها با دقت بسیار بالا تشخیص دادند که نویسنده انسان است.
- اما وقتی مقالات آزمون تافل (TOEFL) که توسط دانشجویان بینالمللی و غیرانگلیسیزبان نوشته شده بود به این ابزارها داده شد، بیش از ۶۱ درصد از مقالات انسانی به عنوان هوش مصنوعی شناسایی شدند!
- در ۱۹ درصد موارد، تمام هر ۷ ابزار به اتفاق آرا مدعی شدند که متن کاملاً کار هوش مصنوعی است، در حالی که نویسنده حتی یک کلمه هم از ابزارهای هوش مصنوعی استفاده نکرده بود.
چرا این اتفاق افتاد؟
دلیل علمی ماجرا بسیار ساده است: یک دانشجو یا محقق وقتی به زبانی رسمی یا زبانی غیر از زبان مادریاش مینویسد، سعی میکند کلمات را دقیق، گرامری، ساده و بدون دستاندازهای عامیانه به کار ببرد.
به زبان ریاضی: نوشتهی یک انسان منضبط، پرپلکسیتی پایین و برستینس یکنواخت پیدا میکند؛ دقیقاً همان چیزی که الگوریتم به اشتباه آن را هوش مصنوعی میداند!
فاجعه دوبرابر در زبان فارسی؛ چرا دیتکتورها در متون فارسی دروغ میگویند؟
اگر این ابزارها در زبان انگلیسی ۶۱ درصد خطا دارند، در زبان فارسی عملاً شبیه به «پرتاب سکه» عمل میکنند. دلایل اصلی این عدم قطعیت عبارتند از:
- فقر شدید دادههای آموزشی (Training Corpora): ابزارهایی مثل CopyLeaks و ZeroGPT دهها میلیارد متن انگلیسی را دیدهاند، اما دیتابیس ارزیابی ساختار نحوی زبان فارسی در آنها بسیار ناچیز است.
- رسمیت ذاتی زبان مقالات در ایران: در فضای دانشگاهی فارسی، استفاده از ساختارهای مجهول، واژگان متین و جملات رسمی استاندارد اجباری است؛ الگوریتم خارجی این رسمیت و انضباط فارسی را به عنوان لحن ماشینی تفسیر میکند.
- مسئله نیمفاصلهها و پیوستگی واژگان: نحوه توکنسازی خط فارسی به دلیل تفاوت در فاصلهگذاری، محاسبات احتمالات ریاضی پرپلکسیتی را در این ابزارها کاملاً به هم میریزد.
نتیجه این است: استادی که در دانشگاه یک پاراگراف از پایاننامه دانشجوی خود را داخل این سایتها میگذارد، با عددی روبهرو میشود که هیچ پشتوانه علمی ندارد. به همین دلیل دانشگاههای بزرگی مانند وندربیلت (Vanderbilt) در آمریکا، استفاده از دیتکتور هوش مصنوعی را به دلیل نقض حقوق دانشجویان رسماً در سیستمهای آموزشی خود خاموش کردند.
چطور متنهای هوش مصنوعی این ابزارها را دور میزنند؟ (تله پارافریز)
مسخرهترین بخش ماجرا اینجاست: در حالی که متون انسانی واقعی مدام متهم میشوند، کافی است متنی که واقعاً توسط هوش مصنوعی نوشته شده را با کمی بازنویسی، تغییر چند کلمه یا افزودن یک غلط املایی ساده تغییر دهید! با همین ترفند ساده، عدد تشابه هوش مصنوعی در این سایتها از ۹۰٪ به صفر میرسد.
این عدم تعادل نشان میدهد که تکیه بر این ابزارها، دانشمندان واقعی را تنبیه و متقلبان باهوش را تشویق میکند. همانطور که در راهنمای هوش مصنوعی برای تحقیق و پایاننامه توضیح دادیم، هوش مصنوعی باید ابزار بارش فکری و اصلاح نگارش باشد، نه جایگزین تفکر و تولید دادههای دستاول.
اگر متهم به استفاده از هوش مصنوعی شدیم چطور از خود دفاع کنیم؟
اگر کارفرما یا استادی مدعی شد که متن شما هوش مصنوعی است، به جای عصبانیت از این ۴ استراتژی حقوقی و منطقی استفاده کنید:
- ارائه تاریخچه تغییرات سند (Version History): همیشه مقالات و پروژههای مهم را در گوگل داکس (Google Docs) یا ورد با قابلیت Track Changes بنویسید. تاریخچهای که نشان دهد شما پاراگرافها را کلمهبهکلمه در طول چند هفته تایپ، پاک و بازنویسی کردهاید، قویترین سند انسانی بودن کار است (هوش مصنوعی کل متن را در ۱ ثانیه پیست میکند).
- ارجاع به پژوهش دانشگاه استنفورد: با آرامش به استادتان توضیح دهید که طبق مقاله علمی استنفورد، خطای مثبت کاذب (False Positive) این ابزارها روی متون آکادمیک بالای ۶۰ درصد است و هیچ پایگاه قضایی یا آموزشی معتبری آن را به عنوان سند اتهام نمیپذیرد.
- جلسه شفاهی (Viva Defense): از استاد بخواهید دربارهی تکتک استدلالها، مراجع و دادههای درون متن از شما سؤال شفاهی بپرسد؛ کسی که خودش متنی را فهمیده و نگاشته باشد، به راحتی از پس استدلالهایش برمیآید.
- ارجاع به دادههای میدانی و محلی: در متنهایتان همیشه از مثالهای روزمره بومی، آزمایشهای اختصاصی و دادههایی نام ببرید که هیچ مدل هوش مصنوعی در سرورهای ابری به آنها دسترسی ندارد.
ابزارهای هوش مصنوعی روزبهروز باهوشتر میشوند و مرز میان متن انسان و ماشین هر روز باریکتر میشود؛ در چنین دنیایی، تکیه بر سایتهای چنددلاری برای تشخیص اصالت انسان، تنها نوع دیگری از توهم هوش مصنوعی است.