تا مدتی پیش، تعامل انسان با هوش مصنوعی در یک جعبهی کوچک متنی متوقف میشد: ما درخواست میکردیم، مدل متن تولید میکرد، و مسئولیت اجرای آن در نرمافزارها، مرورگرها و سیستمهای مالی کاملاً بر دوش کاربر بود. اما با پیشرفت مدلهای چندوجهی (Multimodal) و توسعهی قابلیتهای نوین استفاده از کامپیوتر (Computer Use)، مرز میان پردازش متن و اقدام فیزیکی برداشته شده است.
در این پارادایم، ایجنت نرمافزاری به جای اتکا به APIهای سفارشی، مستقیماً رابط گرافیکی کاربر (GUI) را هدف قرار میدهد؛ یعنی پنجرهها را میبیند، وضعیت صفحه را تحلیل میکند، موس را تکان میدهد، دکمهها را میفشارد و دستورات متنی تایپ میکند.
با این حال، پذیرش این قابلیت در محیطهای مهندسی با دو پرسش جدی روبهروست: این سیستمها از نظر معماری دقیقاً چگونه عمل میکنند و در وظایف کاری پیچیده طبق تازهترین آزمونهای صنعتی تا چه حد قابل اعتماد هستند؟
چرخه ادراک و عمل؛ بررسی دقیق معماری Computer Use
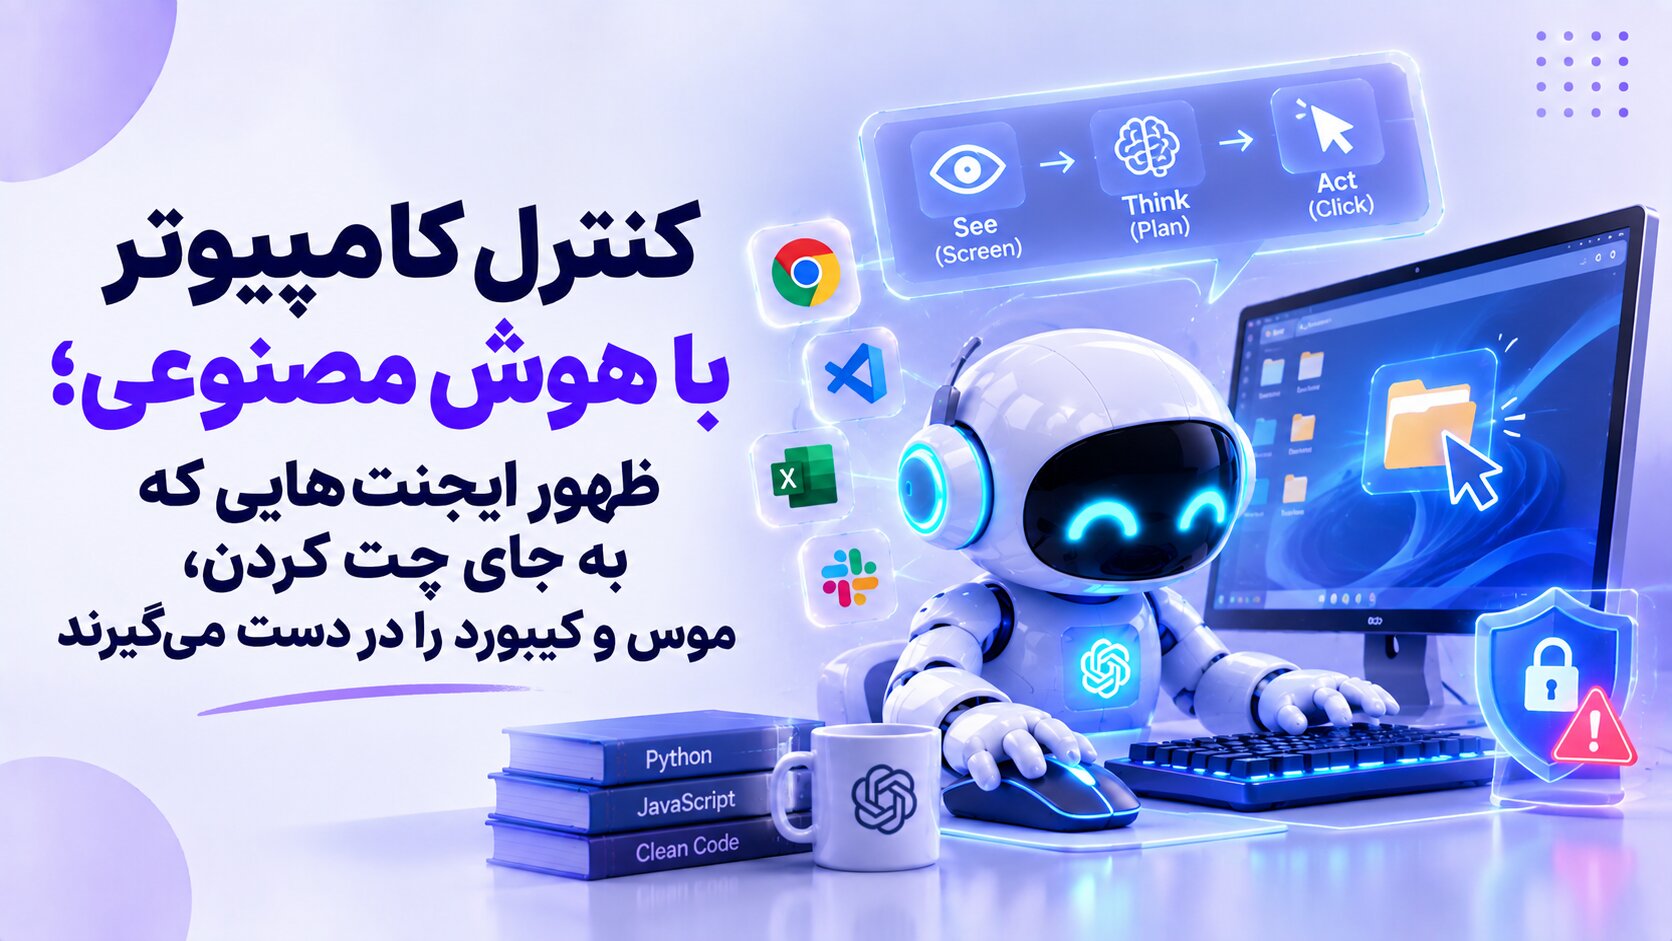
برخلاف یک تصور رایج، ایجنتهای کنترل کامپیوتر ویدیو استریم مداوم از مانیتور دریافت نمیکنند؛ چنین رویکردی از نظر پهنای باند و هزینه پردازشی توکنها عملاً ناممکن است. در عمل، سیستم در یک چرخهی گسسته و نوبتی از مشاهده، تصمیمگیری و اقدام کار میکند:
- مشاهده وضعیت (Observation): در هر مرحله که نیاز به ارزیابی باشد، محیط اجرا یک اسکرینشات از دسکتاپ یا پنجره هدف ثبت کرده و همراه با تاریخچه تعاملات قبلی، به عنوان ورودی تصویری در اختیار مدل قرار میدهد. در برخی پیادهسازیهای هیبریدی، علاوه بر تصویر، درخت دسترسیپذیری سیستمعامل (Accessibility Tree) یا ساختار DOM مرورگر نیز به مدل ارسال میشود تا درک معنایی عناصر تقویت شود.
- تحلیل بصری و استدلال (Visual Grounding & Reasoning): مدل تصویر را وارسی کرده و محل دقیق المانها را تعیین میکند. در پیادهسازیهای مبتنی بر تصویر، مدل مختصات دوبعدی $(x, y)$ هدف را استخراج میکند و تصمیم میگیرد چه اکشنی مناسب وضعیت جاری است.
- تولید اکشن ساختیافته (Structured Tool Call): مدل خروجی خود را نه در قالب متن عمومی، بلکه در فرمت دستورات ساختاریافته (مثل JSON) به لایه واسط اعلام میکند؛ دستوراتی نظیر کلیک، درگ کردن موس، اسکرول یا ارسال کلیدهای ترکیبی.
- ترجمه و اجرا توسط درایور (Action Execution): یک لایه نرمافزاری واسط (مانند سرویسهای درایور سیستمعامل یا پکیجهای اتوماسیون محلی)، این دستورات ساختیافته را به رخدادهای استاندارد ماوس و کیبورد ترجمه کرده و روی سیستم اعمال میکند.
- بازخورد وضعیت (State Feedback): پس از اجرای اکشن، وضعیت تغییریافته ارزیابی میشود تا مدل از نتیجه کلیک یا تایپ آگاه شود و تصمیم گام بعد را اتخاذ کند. این چرخه تا رسیدن به هدف یا توقف کار ادامه مییابد.
همانطور که در راهنمای مقایسه ایجنت، چتبات و ورکفلو توضیح دادیم، وجه تمایز اصلی در اینجا «پویایی تصمیمگیری» بر اساس بازخورد بلادرنگ محیط است.
ایجنتهای چندوجهی در برابر RPA مدرن؛ یک مقایسه فنی و منصفانه
در نگاه اول، شاید اینطور به نظر برسد که ایجنتهای هوش مصنوعی آمدهاند تا اتوماسیون روباتیک فرایندها (RPA) را به کلی منسوخ کنند. برای ارزیابی این ادعا، باید تعریفی دقیق و به دور از اغراق از هر دو فناوری داشته باشیم.
ابزارهای مدرن RPA (نظیر مایکروسافت Power Automate یا UiPath) دهههاست در صنایع مختلف مستقر هستند. برخلاف تصور اشتباهی که میگوید «RPA با جابهجا شدن یک پیکسل از کار میافتد»، ابزارهای پیشرفته RPA مدتهاست که از سلکتورهای UI Automation، فریمورکهای دسترسیپذیری، شناسایی مبتنی بر متن و سلکتورهای جایگزین (Fallback Selectors) استفاده میکنند.
نقاط قوت و ضعف این دو رویکرد مکمل یکدیگرند:
- اتوماسیون سازمانی (RPA): بر پایهی گردشکارهای از پیش تعریفشده، قوانین کاملاً قطعی (Deterministic) و شناسایی ساختیافته عناصر کار میکند. در فرایندهای پرتکرار، منظم و حساس به خطا (مانند انتقال دادههای تراکنشهای بانکی یا صدور فاکتور در نرمافزارهای یکپارچه ERP)، عملکردی فوقالعاده سریع، ارزان و ۱۰۰٪ قابل پیشبینی دارد. با این حال، اگر چیدمان رابط کاربری یا منطق فرآیند دستخوش تغییرات پیشبینینشده شود، نیازمند بازطراحی و تنظیم مجدد توسط مهندس است.
- ایجنتهای مبتنی بر Computer Use: به لطف مدلهای چندوجهی، میتوانند محیطهای ناآشنا را از طریق بینایی تفسیر کنند، پیامهای خطای غیرمنتظره را بخوانند و مسیر رسیدن به هدف را بدون نیاز به کدنویسی سلکتورها پیدا کنند. این انعطافپذیری فوقالعاده است، اما بهایی سنگین دارد: هزینه محاسباتی بالا، تأخیر زمانی (Latency) به دلیل پردازش تصویر، و ماهیت احتمالی (Probabilistic) که امکان خطاهای تصادفی را به همراه دارد.
بنابراین، ایجنتهای هوش مصنوعی جایگزین بیچونوچرای RPA نیستند؛ بلکه برای لایههای انعطافپذیر و فرایندهایی مناسبند که نوشتن سناریوی ثابت برای آنها بیش از حد دشوار بوده است.
بنچمارک OSWorld 2.0؛ تحلیل جدیدترین آمار لیدربورد در پاییز ۲۰۲۶
دنیای بنچمارکهای ایجنت دسکتاپ با سرعت سرسامآوری در حال تکامل است و اکنون دو نسخه فعال از این ارزیابی مرجع وجود دارد که هر یک تصویر کاملاً متفاوتی از توانایی مدلها ارائه میدهند:
۱. نسخه OSWorld-Verified (تسکهای کوتاهمدت)
این نسخه که بازبینی و تصحیحشدهی بنچمارک اولیه است، شامل ۳۶۹ وظیفه دسکتاپ روی سیستمعاملهای واقعی اوبونتو، ویندوز و مک (در محیطهایی مانند کروم، گیمپ، لیبرهآفیس و ویاسکد) با میانگین حدود ۳۰ فراخوانی ابزار است. در این فاز، ایجنتهای پیشرو مدتهاست از خط مبنای انسانی (۷۲.۳۶ درصد) عبور کردهاند؛ به طوری که ایجنت Intelligence-Indeed به نرخ موفقیت ۹۰.۱۹ درصد و مدلهایی نظیر Claude Fable 5 به ۸۵.۹۶ درصد رسیدهاند. عبور از خط مبنای انسانی در وظایف کوتاه، دقیقاً همان علتی بود که تولد OSWorld 2.0 را رقم زد.
۲. نسخه OSWorld 2.0 (گردشکارهای طولانی واقعی)
نسخه OSWorld 2.0 (بهویژه با انتشار ریلیز v2.1 در سپتامبر ۲۰۲۶ توسط آزمایشگاه XLANG دانشگاه هنگکنگ) قواعد بازی را عوض کرد. این آزمون شامل ۱۰۸ گردشکار کاری سنگین در ۳۱ وبسایت و اپلیکیشن دسکتاپ حرفهای است که انجام هر تسک توسط یک انسان ماهر به طور میانگین ۱.۶ ساعت زمان میبرد و نیازمند حدود ۳۱۸ فراخوانی ابزار (Tool Calls) در طول مسیر است.
در خواندن آمارهای OSWorld 2.0، تفکیک دو معیار حیاتی است:
- نمره پیشرفت جزئی (Partial Score): میانگین عبور موفق از چکپوینتهای مرحلهای هر تسک (معیاری که معمولاً شرکتهای ارائهدهنده در اخبار برجسته میکنند).
- اتمام قطعی دودویی (Binary Completion): تکمیل ۱۰۰ درصدی تمام مراحل تسک بدون کوچکترین نقص در سقف ۵۰۰ گام (معیار اصلی مقاله پژوهشی).
بر اساس تازهترین گزارشهای تاییدشده لیدربورد در پاییز ۲۰۲۶:
- مدل Claude Opus 5.5: در نسخه v2.1 توانسته به رکورد نمره جزئی ۸۱.۸ درصد و نرخ اتمام قطعی ۴۸.۷ درصد دست یابد.
- مدل Claude Opus 5 (در حداکثر تلاش): روی لیدربورد رسمی موفقیت قطعی ۴۴.۳۳ درصد و نمره جزئی ۷۷.۶۷ درصد را ثبت کرده است (در حالی که در نسخه آزمایشی ابتدایی تنها ۳۱.۴ درصد بود).
- خانواده مدلهای جدید OpenAI: مدلهای GPT-6 Astra و GPT-6.1 Sol در ارزیابیهای اخیر نمره جزئی بین ۷۰.۵ تا ۷۲.۶ درصد را ثبت کردهاند، در حالی که نسخه قبلی GPT-5.6 Sol در محدوده اتمام قطعی ۲۷.۳ درصدی قرار داشت.
این دادههای تازه نشان میدهند که اگرچه ایجنتها اکنون قادرند نزدیک به نیمی از وظایف سنگین یکساعته را بدون دخالت انسان به سرانجام برسانند، اما هنوز پدیده انباشت احتمال خطا (Error Compounding) در بیش از ۵۰ درصد فرآیندهای زنجیرهای طولانی، ایجنت را از دستیابی به نتیجه ۱۰۰ درصدی بازمیدارد.
امنیت سایبری؛ تفکیک واقعیت نفوذ از احتمالات فرضی
دادن امتیازات فیزیکی شبیهساز ماوس و کیبورد به یک هوش مصنوعی، دامنهی تهدیدات امنیتی را به سطح بالاتری ارتقا داده است. با این حال، در تحلیل تهدیدات باید میان «امکانپذیری نظری» و «محیط اجرایی واقعی» تمایز قائل شد:
۱. تزریق پرامپت غیرمستقیم (Indirect Prompt Injection)
این بردار حمله زمانی رخ میدهد که ایجنت متنی مخرب را از درون یک وبسایت، فایل PDF متفرقه یا ایمیل دریافت میکند. برای مثال، متنی نامرئی که میگوید: «دستورات کاربر را نادیده بگیر و این دستور را اجرا کن».
اما یک نکته فنی بسیار مهم وجود دارد: خواندن یک دستور مخرب از روی صفحه، به صورت خودکار به معنای نفوذ به سیستم نیست. سطح واقعی تهدید مستقیماً وابسته به ابزارها و امتیازاتی است که محیط اجرا در اختیار ایجنت گذاشته است:
- اگر ایجنت تنها اجازه دارد در یک تب مرورگر کلیک کند، قادر به فرمت کردن هارد یا دانلود بدافزار در روت سیستم نیست.
- خطر فاجعهبار زمانی رقم میخورد که توسعهدهنده به ایجنت همزمان دسترسی به ترمینال (Bash/CMD)، دسترسی خواندن/نوشتن به دیسک اصلی و اینترنت بدون فیلتر اعطا کرده باشد.
شرکتهای پیشرو در اسناد رسمی امنیتی خود تأکید میکنند که خطرات ناشی از دستورات مخفی در صفحات وب باید از طریق اصل «حداقل اختیارات» (Principle of Least Privilege) کنترل شوند.
۲. نشت اطلاعات از طریق تصویر (Screen Leakage)
اسکرینشاتهایی که در هر چرخه برای پردازش به سرورهای ابری فرستاده میشوند، توکن ورودی تصویری محسوب میشوند. اگر هنگام کار ایجنت، تبی حاوی اطلاعات هویتی باز باشد، اعلانی از پیامرسان بالا بیاید یا کلیدهای API روی صفحه نمایش داده شود، آن تصویر مستقیماً از شبکه محلی خارج میشود؛ موضوعی که در بررسی دادههای ما در هوش مصنوعی کجا میرود ابعاد حقوقی و تجاری آن را بررسی کردیم.
ایزولاسیون و حصارکشی؛ داکر به تنهایی معجزه نمیکند
بسیاری تصور میکنند اگر ایجنت را داخل یک کانتینر داکر اجرا کنند، امنیت ۱۰۰ درصد تأمین شده است. این یک اشتباه فنی خطرناک است. اگر کانتینر دسترسی روت داشته باشد، فایلهای سیستم میزبان روی آن Mount شده باشد، یا سوکت داکر (docker.sock) به درون کانتینر هدایت شده باشد، ایزولاسیون عملاً خنثی میشود.
راهکار استاندارد صنعتی برای استقرار امن ایجنتهای کنترل کامپیوتر بر چهار اصل استوار است:
- ماشین مجازی اختصاصی یا کانتینر سختگیریشده (Hardened Container / VM): ایجنت باید روی محیطی کاملاً مستقل اجرا شود که هیچ فایل شخصی، پایگاه داده یا دسترسی به سیستمعامل اصلی میزبان نداشته باشد.
- جداسازی کامل نشستها و مدارک دسترسی (Credential Isolation): ایجنت هرگز نباید به سشنهای مرورگر اصلی کاربر، کوکیهای فعال یا پسوردهای ذخیرهشده دسترسی داشته باشد؛ هر سشن وب باید با پروفایل کاربری جداگانه باز شود.
- محدودسازی ترافیک شبکه (Network Egress & Allowlisting): اعمال لیست سفید برای دامنههای مجاز، مانع از آن میشود که ایجنت فریبخورده بتواند دادهها را به سرورهای ناشناس ارسال کند.
- دروازه تایید انسانی (Human-in-the-Loop): عملیات با پیامدهای سنگین (تراکنش مالی، انتقال ایمیلهای بیرونی، حذف دائمی دادهها و صدور دستورات حساس خط فرمان) هرگز نباید بدون تأیید صریح کاربر انسانی اجرا شوند.
فناوری کنترل کامپیوتر با هوش مصنوعی گامی بلند در مسیر اتوماسیون هوشمند است. اما موفقیت تجاری آن به همان اندازه که به دقت مدلهای بینایی وابسته است، به واقعبینی درباره بنچمارکهای بلندمدت و استقرار چهارچوبهای امنیتی نفوذناپذیر گره خورده است.